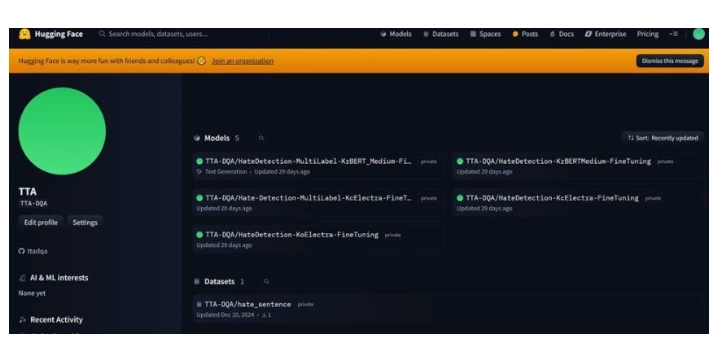
한국정보통신기술협회(TTA)가 대형언어모델(LLM) 학습용 데이터의 유해표현을 검출할 수 있는 인공지능(AI) 모델을 개발했다고 3일 밝혔다. 해당 모델은 한국지능정보사회진흥원(NIA)의 ‘2024년 초거대AI 학습용 데이터 품질검증 사업’의 일환으로 제작됐다. TTA가 개발한 유해표현 검출 AI모델은 말뭉치…
SNS 계정으로 로그인
아직 계정이 없으신가요? 회원가입 →